
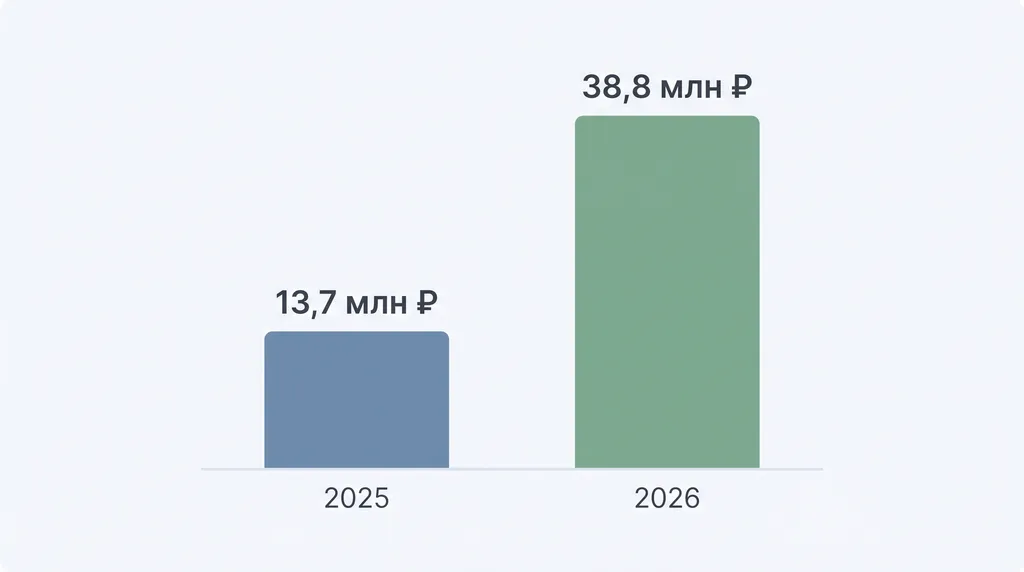
Средняя стоимость минимального набора ускорителей Nvidia для запуска одной языковой модели в России выросла с 13,7 млн ₽ в 2025 году до 38,8 млн ₽ в 2026-м. В эту сумму вошли только серверы с GPU и коммутаторы к ним — без интеграции, людей, лицензий и самой модели. Даже как нижняя граница она меняет исходную посылку: собственный контур больше не выглядит способом сэкономить на ИИ.
Ниже — что именно подорожало, почему вендоры продолжают продавать локальный инференс как экономию и что считать руководителю до закупки.
Минимальный контур подорожал в 2,8 раза
Оценку дала MWS Cloud, входящая в «МТС Web Services». Аналитики сравнили требования к инфраструктуре для запуска ведущих открытых моделей, вышедших весной и летом двух лет.
Вот их вывод: «средняя стоимость минимального набора ускорителей Nvidia для развертывания одной ИИ-модели выросла с 13,7 млн руб. в 2025 г. до 38,8 млн руб. в 2026 г. — то есть в 2,8 раза».
Расчёт исходил из минимального количества видеокарт, нужного для запуска модели и обработки одного запроса максимального заявленного размера. Интеграция, лицензии и персонал в него не входили.
Сравнивались модели, вышедшие весной и летом двух лет: в 2025-м — Kimi K2, gpt-oss-120b, Gemma 3 27B, GLM-4.5V, Qwen3 235B и российская Cotype Pro 2, в 2026-м — Kimi K3, Qwen3.5 397B, DeepSeek-V4-Pro, GLM-5.2, Gemma 4 и Cotype Pro 3. Причина роста сформулирована прямо: новые модели «требуют больше видеопамяти и более производительных ускорителей». Это сопоставление «лето к лету», а не календарный год к году, и методику MWS не публикует.
Рост не привязан к одному поставщику железа. На ускорителях Huawei Ascend 910B средняя потребность на модель выросла с 10,7 штуки в 2025 году до 13,6 в 2026-м. Гендиректор MWS Павел Воронин добавляет, что рынок ждёт продолжения: «47% респондентов ожидают удорожания GPU-ресурсов до осени 2027 г., а 45% считают, что их значение для бизнеса будет расти».
Память, а не модели: что на самом деле двигает цену
Дело не только в размере моделей. По данным Bloomberg, о которых пишет РБК, «крупнейшие клиенты Nvidia получили уведомления о росте стоимости серверов, оснащенных чипами для искусственного интеллекта, в ряде случаев подорожание превысит 15%». Речь о системах на флагманских чипах Vera Rubin и Grace Blackwell; о подорожании уже уведомлены Microsoft и Google.
Причина — не вычислительные ядра, а память. «Производители памяти: Samsung Electronics, SK Hynix и Micron Technology — получили беспрецедентное влияние на рынок, так как их производственные мощности не успевают за спросом на ИИ-инфраструктуру». Внутри года цена узла задаётся дефицитом DRAM, а не архитектурой ускорителя.
Gartner считает общий счёт: мировые расходы на ИИ в 2026 году — 2,7 трлн долларов, рост 49,5% год к году, из них 1,48 трлн приходится на инфраструктуру. При этом спрос на неё «остаётся сильным и неэластичным к давлению от роста цен на память». То есть рынок в целом не притормозит, а смета отдельной компании всё равно вырастет.
Вендоры считают ту же экономику другими величинами
Расхождение начинается с единицы измерения. Nvidia меряет стоимость готового токена и берёт масштаб стойки: «системы Vera Rubin NVL72 дают в 30 раз больше пропускной способности на мегаватт и в 45 раз меньшую стоимость токена, чем NVIDIA GB300 NVL72». Условие — полная загрузка стойки на 72 GPU; агентные нагрузки при этом потребляют в 15 раз больше токенов, чем простой чат-запрос.
Apple продаёт противоположный тезис — про вход, а не про токен. «Они дешевле, чем аренда дата-центров», — так компания обращается к корпоративным покупателям, предлагая Mac mini и Mac Studio стоимостью до 20 тыс. долларов. Главный аргумент — исчезновение счётчика.
There's no cost per token. You're just using the machine again and again.
Джони Сруджи, директор по аппаратному обеспечению Apple (Reuters, 22 сентября 2026)
Microsoft играет на том же поле: локальный ИИ на устройстве там называют «неизмеряемым по счётчику интеллектом». Но в собственном блоге Azure экономика описана иначе: «число, которое важно бизнесу, — стоимость успешного результата, а не цена токена». Один завершённый результат агента может стоить дюжины обращений к модели, и любая расточительность в цикле умножается.
| Кто считает | Величина | Что показывает |
|---|---|---|
| MWS Cloud | Цена входа в контур | 38,8 млн ₽ на одну модель, без интеграции и людей |
| Nvidia | Стоимость миллиона токенов | До 45 раз дешевле на стойке NVL72 при полной загрузке |
| Apple | Цена устройства | Платы за токен нет, машина работает без счётчика |
| Microsoft | Стоимость успешного результата | Один результат — дюжина запросов, издержки цикла умножаются |
| Gartner | Мировые расходы | 2,7 трлн долларов в 2026 году, 1,48 трлн — инфраструктура |
Почему в России это другой выбор
Российские компании называют барьеры сами. По исследованию «Инфосистемы Джет» и Smart Ranking, для 58% главное препятствие — стоимость серверов, для 56% — юридические риски, для 42% — ограничения бюджетов, для 40% — дефицит экспертов. Почти половина, 44%, отказывается от ИИ-агентов из-за незрелости процессов и инфраструктуры данных. При этом языковые модели используют или пилотируют 86% крупных компаний, а 53% уже вывели решения на генеративном ИИ в промышленную эксплуатацию.
Ответ рынка на удорожание железа описан в той же оценке MWS: «если покупка ИТ-оборудования в 2026 г. перестает окупаться, российские компании выбирают более компактные ИИ-модели, оптимизируют вычисления или переходят в облако, где можно платить только за фактически используемые мощности». Индикатор сдвига — потребление китайских моделей в облаке MWS: за первое полугодие 2026 года оно более чем в 11 раз превысило весь 2025 год.
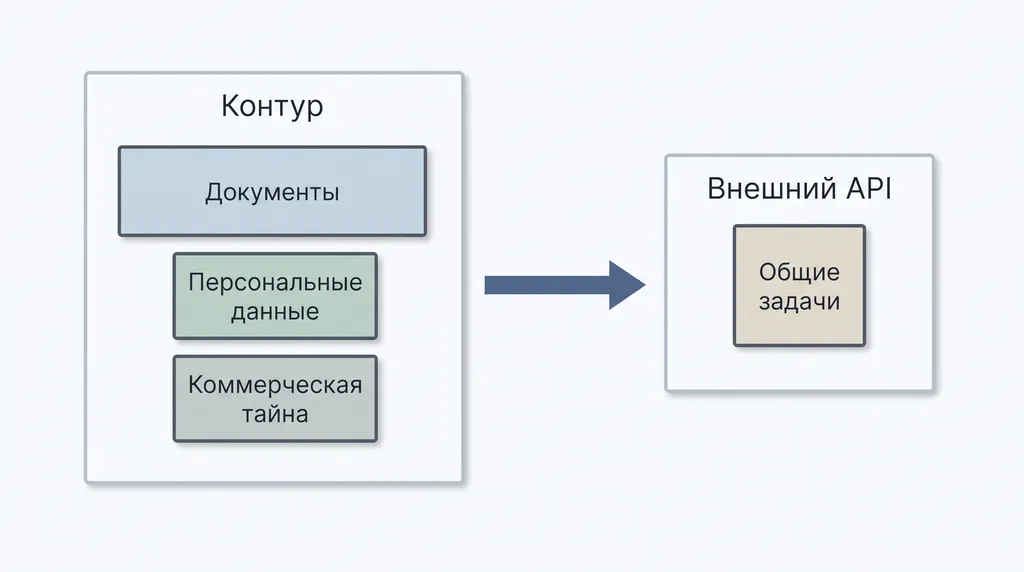
Для западного покупателя суверенность данных — один из рисков, который, по формулировке Gartner, «не останавливает покупателей от перехода на проприетарные возможности». Для российской компании это не риск, а входное условие: часть документов и персональных данных обязана остаться в контуре, и выбирать приходится не между дешёвым и дорогим, а между своим контуром и внешним API для тех задач, где данные можно вынести. Сравнивать варианты удобнее там, где видно состав модели и требования к железу — например, в каталоге моделей.
Что считать до закупки
Цифра в 38,8 млн ₽ — не стоимость проекта, а его нижняя граница. Между этой цифрой и бюджетом внедрения лежат интеграция, люди, лицензии, электропитание и сопровождение модели. Поэтому решение о своём контуре имеет смысл принимать не по прайсу ускорителей, а по расчёту на три года.
- Считать трёхлетний TCO: железо, память, поставка, интеграция, фонд оплаты труда, электричество и сопровождение модели после запуска.
- Разделить задачи: что обязано быть в контуре по закону и договору, а что можно отдать внешнему API без потери контроля над данными.
- Взять единицей планирования стоимость успешного результата, а не цену токена: агентный сценарий — это цикл из десятков обращений.
- Маршрутизировать запросы: отправка всех обращений в старшую модель означает переплату на большинстве из них.
- Заложить удорожание памяти и сроков поставки в план закупки на 2027 год, а не считать по цене прошлого квартала.
- Проверять вендорские цифры на своих данных: материал Nvidia об экономии вышел 24 августа и был переписан 15 сентября — 35-кратное снижение стоимости токена превратилось в 45-кратное внутри трёх недель.
Практический порядок такой: сначала определить, какие сценарии вообще обязаны жить в закрытом контуре, затем посчитать их трёхлетнюю стоимость и только после этого решать, покупать ли ускорители. Сценарии, где данные допустимо выносить, дешевле закрывать внешним API, а не расширять контур — посмотреть, как это разложено по задачам, можно в разделах о сценариях. Если контур всё же нужен, начинать разумнее с одной задачи и одной модели, а не с набора железа под все модели сразу; ориентир по составу такого пилота есть в описании конфигураций.
Частые вопросы
Почему локальный контур подорожал, если сами модели дешевеют?
Дорожает не модель, а память и ускорители. MWS Cloud сравнила минимальные наборы видеокарт для моделей 2025 и 2026 годов: новые требуют больше видеопамяти. По данным Bloomberg, Nvidia уведомила крупнейших клиентов о росте цен на серверы с ИИ-чипами более чем на 15% из-за дефицита DRAM, а Samsung, SK Hynix и Micron получили беспрецедентное влияние на рынок.
Что входит в 38,8 млн ₽ и что осталось за сметой?
В оценку MWS Cloud вошли только серверы с графическими процессорами и коммутаторы к ним — минимум, нужный для запуска модели и обработки одного запроса максимального размера. Интеграция, лицензии, фонд оплаты труда, электропитание и сопровождение модели в сумму не входят, поэтому 38,8 млн ₽ — нижняя граница проекта, а не его стоимость.
Когда выгоднее внешний API, а когда собственный контур?
Разделять стоит по данным, а не по цене. Задачи, где обрабатываются персональные данные, коммерческая тайна или документы с ограниченным доступом, обязаны остаться в контуре. Остальное дешевле закрывать внешним API: 58% российских компаний называют стоимость серверов главным барьером, а 44% отказываются от агентов из-за незрелости инфраструктуры и данных.
На сколько ещё подорожает железо?
Точного потолка не называет никто. По опросу MWS Cloud, 47% респондентов ожидают удорожания GPU-ресурсов до осени 2027 года. Gartner при этом фиксирует, что мировой спрос на ИИ-инфраструктуру остаётся неэластичным к росту цен на память, — значит, рассчитывать на быстрое снижение цен на вход в контур не стоит.
Источники
- В России зафиксирован почти трехкратный рост стоимости внедрения ИИ — CNews, 19 августа 2026 г.
- Bloomberg узнал, что Nvidia повышает цены на серверы c ИИ-чипами — РБК, 23 августа 2026 г.
- Up to 30x More Work Per Watt: NVIDIA Vera Rubin NVL72 Sets a New Efficiency Standard for AI Agents — NVIDIA Blog, 24 августа 2026 г.
- Исследование «Инфосистемы Джет»: 86% крупных российских компаний уже используют большие языковые модели — CNews, 26 августа 2026 г.
- The Economics of Agent Optimization: Four ways to lower the cost — Microsoft Azure Blog, 26 августа 2026 г.
- Gartner Forecasts Worldwide AI Spending to Grow 49.5% in 2026 — Gartner, 16 сентября 2026 г.
- With new Macs, Apple aims to take on Microsoft, Nvidia in a rush to lower AI costs — Reuters, 22 сентября 2026 г.